Prólogo
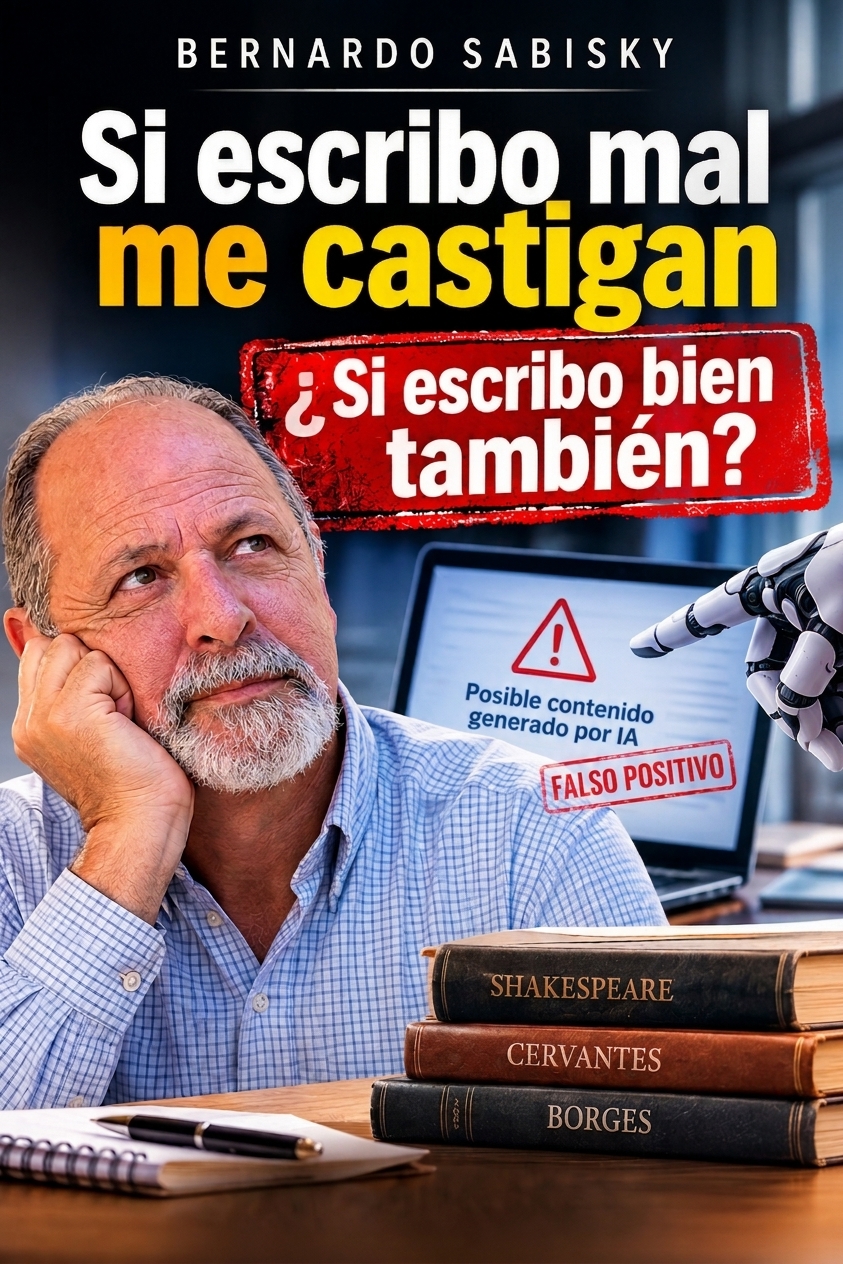
Las herramientas que prometen identificar textos generados por inteligencia artificial están en el centro de una controversia científica, educativa y ética. Diversas investigaciones demostraron que pueden señalar como artificiales trabajos escritos íntegramente por personas, especialmente cuando presentan un vocabulario limitado, una estructura gramatical ordenada o un estilo formal. Los falsos positivos, las dificultades para detectar contenidos modificados y las decisiones de universidades que comenzaron a abandonar estos sistemas plantean una pregunta incómoda: ¿puede una tecnología diseñada para combatir el fraude terminar perjudicando a quienes trabajan honestamente?
La irrupción de la inteligencia artificial generativa modificó profundamente la relación entre escritura, conocimiento y evaluación. Desde la aparición de herramientas capaces de producir ensayos, informes, artículos y respuestas académicas en cuestión de segundos, instituciones educativas y organizaciones profesionales comenzaron a buscar mecanismos para distinguir la producción humana de la automatizada.
La reacción parecía lógica. Si una máquina puede elaborar un trabajo completo, también debería existir alguna herramienta capaz de reconocerlo. Sobre esa premisa se desarrolló un mercado de detectores de inteligencia artificial que promete analizar documentos, identificar patrones lingüísticos y estimar la probabilidad de que un contenido haya sido producido por un modelo generativo.
Sin embargo, la realidad resultó bastante más compleja.
Con el paso del tiempo, distintas investigaciones comenzaron a documentar errores de clasificación que pusieron en cuestión la confiabilidad de estos sistemas. Los problemas no se limitan a textos generados por inteligencia artificial que logran pasar inadvertidos. También incluyen situaciones inversas: escritos auténticos, elaborados por estudiantes, investigadores y profesionales, que reciben puntuaciones elevadas de supuesta autoría artificial.
La paradoja es especialmente preocupante porque algunos de los rasgos que tradicionalmente se consideran virtudes de la escritura —precisión, claridad, coherencia, corrección gramatical y uniformidad estilística— pueden coincidir con características estadísticas que determinados detectores asocian con la producción automatizada.
Así, una herramienta concebida para identificar posibles irregularidades puede terminar cuestionando precisamente aquello que debería reconocer: el trabajo intelectual bien realizado.
1. El problema comienza en la manera en que los detectores interpretan un texto
Para comprender la controversia es necesario distinguir entre dos operaciones que suelen confundirse: analizar las características de un documento e identificar quién lo escribió.
Un detector puede encontrar regularidades estadísticas, secuencias de palabras previsibles y determinadas estructuras sintácticas. También puede comparar esos elementos con patrones asociados a textos generados por modelos de lenguaje.
Pero ninguna de esas operaciones permite observar directamente el proceso de escritura ni conocer, por sí sola, la identidad de su autor.
Herramientas como GPTZero, ZeroGPT, Copyleaks y los sistemas incorporados en plataformas educativas utilizan metodologías diferentes. Algunas recurren a clasificadores entrenados con muestras humanas y sintéticas; otras combinan distintos indicadores lingüísticos y modelos estadísticos.
Aunque sus procedimientos no son idénticos, dos conceptos resultan especialmente importantes para entender las limitaciones de los métodos tradicionales: la perplejidad (perplexity) y la variabilidad sintáctica (burstiness).
La perplejidad: cuando lo previsible se interpreta como artificial
La perplejidad es una medida estadística que permite estimar qué tan sorprendente resulta una secuencia de palabras para un modelo de lenguaje.
En términos sencillos, un modelo intenta anticipar qué palabra podría aparecer después de otra, teniendo en cuenta el contexto anterior. Si una secuencia utiliza expresiones frecuentes y construcciones convencionales, el sistema puede predecirla con relativa facilidad. En ese caso, la perplejidad será baja.
Por el contrario, una combinación de palabras menos habitual o una construcción lingüística inesperada puede elevar ese indicador.
El problema aparece cuando se interpreta una baja perplejidad como una señal suficiente de generación artificial.
Una persona que domina un idioma, conoce las convenciones de escritura académica y organiza cuidadosamente sus argumentos puede producir un documento con una estructura altamente previsible. Lo mismo ocurre con un abogado que redacta un contrato, un investigador que prepara un informe técnico o un periodista que trabaja bajo normas editoriales estrictas.
En todos esos casos, la previsibilidad puede responder a la formación, la experiencia y el propósito comunicativo del autor, no necesariamente a la intervención de una máquina.
La ráfaga sintáctica: la importancia del ritmo de las oraciones
El segundo concepto es la ráfaga sintáctica, que describe las variaciones en la extensión y complejidad de las oraciones.
En una conversación informal, una persona puede alternar frases muy breves con explicaciones extensas, incorporar aclaraciones entre paréntesis o modificar el ritmo de su exposición según la importancia de cada idea.
En cambio, un documento académico o institucional suele responder a criterios de uniformidad. Sus oraciones pueden mantener una extensión semejante, sus párrafos seguir una organización constante y sus argumentos avanzar mediante una estructura cuidadosamente planificada.
Esta regularidad puede reducir la variabilidad sintáctica.
Algunos detectores consideran esas características dentro de sus evaluaciones. Sin embargo, una escritura uniforme no demuestra que exista generación automática. Puede ser simplemente el resultado de una decisión editorial o de una metodología de redacción.
La distinción es fundamental: reconocer un patrón lingüístico no equivale a demostrar una conducta.
Por eso, incluso cuando un sistema identifica características compatibles con determinados textos generados por IA, su resultado debe interpretarse como una estimación y no como una conclusión definitiva sobre la autoría.
2. Stanford documentó un problema de discriminación lingüística
Uno de los antecedentes científicos más importantes de esta discusión fue publicado en julio de 2023 en la revista Patterns.
El trabajo, titulado GPT detectors are biased against non-native English writers, fue elaborado por Weixin Liang, Mert Yuksekgonul, Yining Mao, Eric Wu y James Zou, investigadores vinculados con la Universidad de Stanford.
La investigación examinó siete detectores comerciales mediante dos conjuntos de textos: 91 ensayos TOEFL escritos por estudiantes no nativos de inglés y 88 ensayos de estudiantes estadounidenses de octavo grado, procedentes de una base de datos educativa.
Los resultados mostraron una diferencia considerable entre ambos grupos.
Los detectores clasificaron incorrectamente como artificiales más de la mitad de los ensayos TOEFL, con una tasa promedio de falsos positivos del 61,22%. Además, el 97,80% de esos documentos fue señalado por al menos una de las siete herramientas.
La situación fue todavía más llamativa al observar la coincidencia entre los sistemas: el 19,78% de los ensayos no nativos fue identificado como artificial por los siete detectores simultáneamente.
No se trataba de textos producidos por inteligencia artificial, sino de trabajos humanos utilizados como muestra experimental.
Un experimento que reveló el origen del sesgo
Los investigadores no se limitaron a medir los errores. También intentaron comprender por qué se producían.
Para hacerlo, modificaron la variedad del vocabulario de los ensayos TOEFL mediante ChatGPT, procurando conservar el contenido sustantivo de los textos y enriquecer su expresión lingüística.
El resultado fue significativo: la tasa promedio de falsos positivos descendió del 61,22% al 11,77%.
En una prueba inversa, simplificaron el vocabulario de los ensayos escritos por estudiantes estadounidenses. La tasa de falsos positivos aumentó del 5,19% al 56,65%.
La comparación permitió identificar una relación entre la diversidad léxica y la probabilidad de clasificación equivocada.
Los estudiantes que utilizan un idioma aprendido pueden recurrir a un repertorio de expresiones más acotado, estructuras gramaticales conocidas y combinaciones de palabras relativamente convencionales. Esas características pueden elevar la previsibilidad estadística de sus escritos.
El problema, entonces, no reside necesariamente en la utilización de inteligencia artificial, sino en las limitaciones de un sistema que puede confundir determinadas formas de expresión humana con patrones asociados a la producción automatizada.
La investigación de Stanford advirtió que esta situación puede perjudicar especialmente a quienes escriben en una segunda lengua y recomendó cautela ante la utilización de detectores en contextos educativos.

DOI
+1
Este hallazgo tiene implicancias que exceden el ámbito del inglés. Aunque el estudio se realizó con textos en ese idioma y sus resultados no pueden extrapolarse automáticamente a todas las lenguas, plantea una pregunta relevante para los sistemas de evaluación internacionales: ¿qué sucede cuando un algoritmo interpreta las diferencias de formación lingüística como indicios de fraude?
3. La trampa de la corrección gramatical: cuando escribir con precisión se convierte en una desventaja
El caso de los estudiantes no nativos permite comprender una contradicción que también puede afectar a otros perfiles de escritores: la calidad formal de un documento no siempre coincide con los criterios estadísticos que utilizan los detectores para clasificarlo.
Pensemos en un estudiante que aprendió inglés mediante manuales, ejercicios gramaticales y formación académica. Es probable que haya desarrollado una escritura cuidadosa, con estructuras conocidas, vocabulario específico y escasa utilización de expresiones coloquiales.
Su objetivo es comunicarse correctamente.
Sin embargo, esa misma regularidad puede producir un documento con características que determinados clasificadores interpretan como compatibles con la inteligencia artificial.
Algo semejante puede suceder con profesionales que trabajan bajo normas editoriales estrictas. En disciplinas como el derecho, la medicina, la ingeniería o la investigación científica, la escritura no busca necesariamente sorprender al lector. Busca transmitir información con precisión, evitar ambigüedades y mantener una secuencia argumentativa coherente.
En estos ámbitos, las repeticiones terminológicas, las estructuras convencionales y la uniformidad del registro son recursos funcionales, no defectos.
La situación puede volverse todavía más problemática cuando el autor utiliza herramientas legítimas de asistencia lingüística para revisar ortografía, puntuación y gramática. Una corrección que mejora la presentación de un documento podría modificar sus características estadísticas y, dependiendo del sistema utilizado, alterar su clasificación.
Se produce así una contradicción difícil de justificar: mientras las instituciones recomiendan mejorar las competencias de escritura, determinados mecanismos de control pueden terminar poniendo bajo sospecha los resultados de ese mismo esfuerzo.
El impacto potencial sobre escritores neurodivergentes
La discusión también incluye a personas neurodivergentes, aunque es importante establecer una diferencia metodológica: los estudios citados no demuestran una tasa específica de falsos positivos para cada condición neurodivergente.
Sin embargo, existe una preocupación razonable sobre la posibilidad de que determinadas preferencias comunicativas queden mal representadas en los modelos de clasificación.
Algunas personas pueden favorecer una expresión especialmente literal, una organización lineal de los argumentos, la precisión terminológica o una estructura discursiva sistemática.
En determinados contextos, esos rasgos pueden coincidir con patrones estadísticos de baja variabilidad.
Esto no significa que exista un estilo único de escritura asociado con la neurodivergencia. Tampoco permite concluir que todas las personas neurodivergentes sean más susceptibles a los errores de detección.
Lo que sí plantea es una cuestión de accesibilidad: los sistemas de evaluación deben contemplar la diversidad real de las formas de comunicación humana y evitar que una determinada preferencia estilística se transforme, sin evidencia adicional, en motivo de sospecha.
La evaluación académica no debería exigir que todos escriban de una misma manera para ser considerados autores legítimos.
4. Los textos históricos y la literatura también exponen las limitaciones de los clasificadores
Uno de los argumentos más llamativos en el debate sobre la detección automática es la posibilidad de que documentos escritos mucho antes de la aparición de la inteligencia artificial generativa reciban puntuaciones elevadas de supuesta autoría artificial.
En el material de investigación analizado se mencionan ejemplos como la Constitución de Estados Unidos de 1787 y pasajes del Génesis, además de obras literarias de autores como Jane Austen, Edgar Allan Poe y George Orwell.
La explicación se relaciona con la naturaleza del lenguaje formal y con la manera en que los modelos estadísticos procesan las secuencias de palabras.
Un documento jurídico, por ejemplo, suele utilizar expresiones convencionales, construcciones gramaticales estables y una organización argumentativa previsible. La literatura clásica, por su parte, puede presentar estructuras narrativas y patrones lingüísticos reconocibles, especialmente cuando se analizan fragmentos aislados.
Estas características pueden generar resultados inesperados en herramientas que utilizan patrones estadísticos para evaluar la procedencia de un escrito.
Sin embargo, es necesario evitar una interpretación equivocada: que un detector clasifique erróneamente un documento histórico no demuestra, por sí solo, cuál es el mecanismo exacto que provocó el resultado.
Para establecer esa relación sería necesario conocer el modelo utilizado, el fragmento evaluado, las condiciones de la prueba y los criterios de clasificación.
También hay que considerar que una puntuación de probabilidad ofrecida por una herramienta comercial no siempre representa una probabilidad estadística calibrada de autoría artificial.
El problema de confundir familiaridad lingüística con procedencia
Los grandes modelos de lenguaje se entrenan con cantidades muy importantes de información textual. Durante ese proceso aprenden regularidades del idioma, relaciones entre palabras y estructuras que aparecen con frecuencia en los documentos utilizados para su entrenamiento.
Cuando un detector analiza un texto, puede encontrar patrones que también aparecen en contenidos generados por esos modelos.
Pero una coincidencia estadística no permite establecer una relación causal.
Un documento histórico puede ser previsible porque pertenece a un género formal. Un artículo científico puede utilizar estructuras repetidas porque responde a las convenciones de su disciplina. Una novela puede mantener una voz narrativa consistente porque su autor tomó una decisión estilística.
En todos esos casos, la regularidad tiene una explicación humana perfectamente legítima.
La lección es importante: los algoritmos pueden encontrar semejanzas entre textos sin comprender necesariamente las circunstancias históricas, culturales o intelectuales que dieron origen a cada uno.
5. La vulnerabilidad técnica: detectar textos artificiales tampoco es una tarea sencilla
La discusión no termina con los falsos positivos. Existe otro problema de signo contrario: los textos generados mediante inteligencia artificial pueden modificar sus características y escapar a los mecanismos de detección.
Esto significa que un sistema puede señalar incorrectamente a una persona que escribió por sus propios medios y, al mismo tiempo, no reconocer un documento que efectivamente fue producido con asistencia automatizada.
En términos técnicos, se trata de dos tipos de error diferentes:
-
Falso positivo: un texto humano es clasificado como generado por inteligencia artificial.
-
Falso negativo: un texto producido por inteligencia artificial es clasificado como humano.
Ambos errores comprometen la utilidad de una herramienta cuando sus resultados se utilizan para tomar decisiones importantes.
Qué sucede cuando un texto generado se modifica
Una de las dificultades centrales es que los detectores no analizan una marca universal e inalterable que identifique a la inteligencia artificial.
En general, buscan características lingüísticas y estadísticas que pueden cambiar cuando se modifica un documento.
La investigación de Liang y sus colaboradores mostró que intervenciones sobre el vocabulario podían alterar considerablemente los resultados de los clasificadores.
Por otra parte, los trabajos de Vinu Sankar Sadasivan y sus colaboradores, publicados en 2023, analizaron los límites teóricos de la detección de contenido generado mediante modelos de lenguaje.
Su planteo parte de una dificultad fundamental: si los sistemas generativos consiguen producir textos cada vez más parecidos a los escritos por personas, distinguir ambas procedencias exclusivamente mediante el análisis del resultado final se vuelve progresivamente más difícil.
En ese escenario, la diferencia estadística entre las dos categorías puede reducirse hasta limitar seriamente la capacidad de cualquier clasificador.
Los investigadores también estudiaron cómo las modificaciones lingüísticas y el parafraseo afectan la eficacia de diferentes métodos de detección.
La cuestión tiene una consecuencia directa para las instituciones: un detector no necesariamente identifica el uso de inteligencia artificial, sino que evalúa las características observables de un documento bajo determinadas condiciones.
Por eso, no debería confundirse la ausencia de una alerta con una garantía de autoría humana, del mismo modo que una alerta no demuestra automáticamente una utilización indebida.
6. Un estudio internacional encontró fallas en 14 herramientas de detección
Las dudas sobre la confiabilidad de estos sistemas también fueron examinadas por un equipo internacional encabezado por Debora Weber-Wulff.
La investigación, titulada Testing of detection tools for AI-generated text, fue publicada el 25 de diciembre de 2023 en el International Journal for Educational Integrity.
El trabajo evaluó 14 herramientas: 12 disponibles públicamente y dos sistemas comerciales utilizados en entornos educativos, Turnitin y PlagiarismCheck.
El objetivo era determinar si las tecnologías disponibles podían diferenciar de manera confiable entre textos humanos y producciones de ChatGPT, además de analizar el impacto de la traducción automática y las modificaciones de contenido.
Los resultados fueron contundentes.
Ninguna de las herramientas examinadas superó el 80% de precisión general y solamente cinco alcanzaron el 70%.
Los investigadores también encontraron problemas en ambas direcciones: documentos humanos identificados incorrectamente como artificiales y textos generados por inteligencia artificial que no eran reconocidos como tales.
Otro aspecto relevante fue el efecto de las modificaciones lingüísticas. Las técnicas de ocultamiento y transformación del contenido redujeron considerablemente el rendimiento de los sistemas analizados.
La investigación concluyó que las herramientas evaluadas no ofrecían niveles suficientes de precisión y confiabilidad para resolver por sí solas cuestiones de integridad académica.
Esto no significa que todos los detectores actuales tengan exactamente el mismo rendimiento ni que sus capacidades permanezcan invariables desde 2023. Las tecnologías evolucionan, se actualizan y modifican sus modelos.
Sin embargo, el estudio constituye un antecedente científico importante porque demuestra que las promesas comerciales de detección deben contrastarse con pruebas independientes, metodologías transparentes y evaluaciones realizadas sobre poblaciones diversas.

Springer Nature Link
+1
7. OpenAI retiró su propio detector después de reconocer sus limitaciones
Uno de los episodios más significativos de esta controversia ocurrió en julio de 2023, cuando OpenAI discontinuó su herramienta AI Text Classifier.
El sistema había sido presentado como un mecanismo para estimar si un texto había sido generado por inteligencia artificial. Su lanzamiento respondía a la creciente demanda de herramientas capaces de ayudar a docentes y organizaciones a identificar contenidos automatizados.
Sin embargo, su desempeño estuvo por debajo de lo esperado.
En una evaluación realizada sobre un conjunto de textos en inglés, la herramienta identificó correctamente solamente el 26% de los documentos generados por inteligencia artificial. Además, clasificó erróneamente como artificiales el 9% de los textos humanos examinados.
La empresa reconoció que el clasificador presentaba una baja precisión y dificultades particulares para evaluar documentos breves y contenidos modificados.
El 20 de julio de 2023, OpenAI anunció que dejaría de ofrecer el servicio debido a esas limitaciones.
La decisión tuvo un valor simbólico importante. No se trataba de una empresa ajena al desarrollo de modelos generativos cuestionando un producto de terceros, sino de la propia compañía creadora de ChatGPT reconociendo que su herramienta de detección no alcanzaba un nivel de confiabilidad suficiente.
El episodio también dejó una enseñanza para las instituciones educativas: desarrollar un modelo capaz de producir lenguaje y construir otro que determine de manera confiable quién produjo un texto son problemas tecnológicos diferentes.
Que una empresa domine la primera tarea no garantiza que pueda resolver la segunda.
DOI
+1
8. Las universidades comienzan a reconsiderar el uso de detectores de IA
Las limitaciones técnicas dejaron de ser una discusión exclusivamente académica cuando comenzaron a influir en las políticas de las universidades.
Uno de los casos más representativos fue el de la Universidad de Vanderbilt, en Estados Unidos.
El 16 de agosto de 2023, la institución anunció que desactivaría la función de detección de inteligencia artificial de Turnitin en su campus.
La decisión estuvo relacionada con distintas preocupaciones: la falta de transparencia sobre el funcionamiento del sistema, la posibilidad de errores de clasificación y los riesgos de utilizar resultados automatizados para evaluar la conducta de los estudiantes.
El cálculo de Vanderbilt: 750 trabajos potencialmente afectados
Uno de los argumentos más concretos presentados por la universidad fue un ejercicio de extrapolación estadística.
Turnitin había comunicado una tasa de falsos positivos del 1% para su herramienta. Vanderbilt utilizó ese porcentaje como referencia y lo aplicó a los 75.000 trabajos académicos que sus estudiantes habían entregado durante 2022.
El resultado fue de aproximadamente 750 trabajos que podrían haber recibido una clasificación incorrecta si la herramienta hubiera operado sobre ese volumen de documentos.
La universidad también señaló que existían preocupaciones sobre el funcionamiento interno del sistema y su posible sesgo contra estudiantes cuya lengua materna no era el inglés.
No se trataba de afirmar que 750 alumnos habían sido efectivamente acusados, sino de dimensionar el riesgo potencial que representaba una tasa de error aparentemente pequeña cuando se aplicaba a una cantidad elevada de trabajos.
La diferencia es importante. Un porcentaje reducido puede producir consecuencias significativas cuando se utiliza para tomar decisiones sobre miles de personas.
La institución sostuvo que el software no constituía un mecanismo suficientemente efectivo para determinar por sí solo si un trabajo había sido elaborado mediante inteligencia artificial.

Vanderbilt University
+1
Una transformación en la manera de entender la integridad académica
El caso Vanderbilt no demuestra que todas las universidades hayan abandonado los detectores, ni que exista una política internacional uniforme.
Sí evidencia un cambio en la discusión institucional.
Cada vez resulta más importante distinguir entre utilizar una herramienta como indicador preliminar y convertir su resultado en fundamento de una sanción.
Una alerta puede justificar que un docente examine un trabajo con mayor atención. Lo que no debería hacer es reemplazar la investigación, el diálogo con el estudiante y la evaluación de las pruebas disponibles.
La integridad académica requiere procedimientos justos, información verificable y oportunidades reales de defensa.
Cuando una decisión disciplinaria depende de un resultado probabilístico que el estudiante no puede comprender ni cuestionar, aparece un problema de transparencia que excede las capacidades técnicas del software.
9. El problema de los falsos positivos y sus consecuencias humanas
Detrás de las estadísticas existe una dimensión que suele quedar relegada en las discusiones sobre tecnología: las consecuencias que una clasificación equivocada puede tener para una persona.
En el ámbito universitario, una acusación de utilización indebida de inteligencia artificial puede desencadenar procedimientos disciplinarios, cuestionamientos sobre la integridad del estudiante, pérdida de oportunidades académicas y deterioro de su reputación.
El impacto no termina necesariamente cuando se demuestra que el trabajo fue realizado de manera legítima. La sospecha puede permanecer y afectar la relación entre el estudiante y la institución.
También hay una dimensión psicológica. Cuando una persona descubre que su forma habitual de escribir puede interpretarse como una señal de fraude, comienza a preguntarse si debe modificar su estilo para evitar problemas.
Es una situación especialmente contradictoria para quienes dedican tiempo a mejorar su expresión escrita.
Cuando el estudiante empieza a escribir pensando en el algoritmo
Uno de los riesgos más importantes es que los detectores terminen condicionando la conducta de quienes son evaluados.
Si un estudiante cree que las oraciones demasiado ordenadas, el vocabulario preciso o la coherencia argumentativa pueden generar una alerta, podría comenzar a modificar deliberadamente su manera de escribir.
En lugar de concentrarse en construir argumentos sólidos, puede sentirse obligado a introducir variaciones innecesarias, abandonar expresiones que considera adecuadas o alterar la organización de sus ideas.
El problema es que ese comportamiento invierte el sentido de la enseñanza.
La educación debería incentivar la claridad, el pensamiento crítico y la capacidad de comunicar conceptos complejos. No debería promover que una persona empobrezca su escritura para satisfacer las expectativas estadísticas de un programa informático.
Además, se genera una asimetría difícil de justificar: un autor que escribe correctamente puede quedar bajo sospecha, mientras que un contenido generado mediante inteligencia artificial puede pasar inadvertido después de sufrir determinadas modificaciones.
El resultado es un sistema que corre el riesgo de premiar la apariencia de espontaneidad por encima de la calidad intelectual.
10. El desafío regulatorio: las decisiones automatizadas necesitan supervisión humana
La controversia también tiene implicancias jurídicas y regulatorias.
En la Unión Europea, el Reglamento de Inteligencia Artificial (AI Act) establece obligaciones específicas para determinados sistemas utilizados en el ámbito educativo.
La normativa contempla como aplicaciones de alto riesgo, bajo determinadas condiciones, los sistemas destinados a evaluar resultados de aprendizaje, orientar procesos educativos o influir en decisiones relevantes sobre las personas.
Esto no significa que cualquier detector de inteligencia artificial quede automáticamente incluido en esa categoría. La clasificación depende de su finalidad, sus características y el uso concreto que se haga de la tecnología.
Sin embargo, el marco regulatorio refleja una preocupación central: cuando los sistemas automatizados intervienen en decisiones capaces de afectar los derechos y las oportunidades de una persona, deben existir garantías adecuadas de transparencia, supervisión y control.
En el terreno académico, esta exigencia resulta especialmente importante.
Una puntuación algorítmica no debería reemplazar el criterio profesional del docente ni convertirse en el único fundamento de una acusación de fraude.
La responsabilidad de evaluar un trabajo continúa siendo institucional. No puede trasladarse íntegramente a un proveedor tecnológico ni a una clasificación que el propio estudiante posiblemente no tenga herramientas para interpretar.
La discusión también alcanza la privacidad. Los trabajos académicos contienen información personal, datos de investigación y, en ocasiones, contenidos confidenciales. Por eso, antes de cargar documentos en plataformas externas, las instituciones deberían analizar sus condiciones de tratamiento, almacenamiento y utilización de la información.
La incorporación de tecnología no elimina las obligaciones de protección de datos ni las responsabilidades de quienes administran los sistemas educativos.
11. Qué alternativas existen para evaluar el trabajo humano sin depender de un detector
Si los clasificadores automáticos presentan limitaciones, la respuesta no debería consistir en abandonar toda forma de control.
La utilización indebida de inteligencia artificial plantea desafíos reales para la educación, la investigación y el mundo profesional. Las instituciones necesitan mecanismos que permitan establecer reglas claras, verificar conocimientos y garantizar que los trabajos presentados respondan a los objetivos de cada actividad.
La alternativa consiste en cambiar el centro de la evaluación: dejar de concentrarse exclusivamente en el documento terminado y comenzar a observar también el proceso mediante el cual fue elaborado.
Este enfoque permite reunir evidencias diferentes y complementarias.
1. Historial de versiones y trazabilidad documental
Una de las alternativas consiste en analizar la evolución de un documento mediante su historial de modificaciones.
Plataformas como Google Docs y Microsoft Word ofrecen funciones que permiten consultar versiones anteriores, observar cambios y reconstruir parte del proceso de edición.
Un trabajo puede pasar por distintas etapas: investigación, selección de fuentes, elaboración de un esquema, redacción de borradores, reorganización de párrafos y corrección final.
La existencia de esas etapas permite comprender mejor cómo se desarrolló el documento.
No obstante, es importante mantener el rigor: un historial de versiones tampoco demuestra de manera absoluta quién realizó cada modificación ni garantiza por sí solo que no se haya utilizado inteligencia artificial. Es una evidencia complementaria, no una certificación infalible.
Su utilidad aumenta cuando se combina con otros elementos de evaluación.
2. Consignas contextualizadas y vinculadas con el aprendizaje
Otra alternativa consiste en diseñar actividades que exijan trabajar con contenidos específicos del curso.
Por ejemplo, un docente puede solicitar que los estudiantes relacionen un concepto teórico con un debate desarrollado en clase, analicen un documento primario o comparen diferentes interpretaciones de un acontecimiento.
Este tipo de consignas permite evaluar la comprensión del material y la capacidad de establecer relaciones entre conocimientos.
También facilita que el estudiante demuestre cómo utiliza las fuentes, por qué selecciona determinados argumentos y de qué manera construye una conclusión.
La clave no es elaborar preguntas artificialmente complicadas, sino proponer actividades que permitan observar el razonamiento.
3. Evaluaciones escalonadas y entregas intermedias
Las actividades complejas pueden dividirse en diferentes instancias.
En lugar de solicitar únicamente un trabajo terminado, el docente puede establecer entregas sucesivas:
-
Una propuesta inicial del tema.
-
Un esquema de investigación.
-
Una selección comentada de bibliografía.
-
Un primer borrador.
-
Una versión corregida.
-
Un documento final acompañado de una reflexión sobre el proceso.
Este mecanismo ofrece una visión más amplia del desarrollo del aprendizaje.
También permite identificar dificultades, realizar correcciones tempranas y acompañar al estudiante durante la elaboración del trabajo.
La evaluación deja de ser una fotografía aislada del resultado y se convierte en un seguimiento de la construcción del conocimiento.
4. Defensas orales y diálogo sobre el proceso intelectual
Las presentaciones orales constituyen otra herramienta relevante.
Un estudiante que elaboró un trabajo debería poder explicar sus principales argumentos, justificar la selección de fuentes y responder preguntas relacionadas con sus conclusiones.
Esto no implica que todas las personas deban expresarse oralmente con idéntica facilidad. Las instancias de verificación deben contemplar adaptaciones razonables cuando sean necesarias.
Lo importante es comprobar el dominio conceptual del contenido mediante procedimientos adecuados y proporcionales.
Una conversación académica bien diseñada puede aportar información que ningún análisis estadístico del documento final consigue proporcionar por sí solo.
5. Políticas transparentes sobre el uso de inteligencia artificial
También resulta indispensable que las instituciones definan qué usos están permitidos, cuáles están restringidos y cuándo corresponde declarar la intervención de una herramienta generativa.
No todas las actividades académicas tienen los mismos objetivos.
En una evaluación destinada a comprobar la capacidad individual de redacción, el uso de un generador automático puede estar limitado. En un proyecto de investigación, en cambio, puede permitirse utilizar inteligencia artificial para explorar bibliografía, organizar información o revisar determinados aspectos del documento, siempre bajo condiciones explícitas.
La transparencia evita que estudiantes y docentes trabajen con expectativas diferentes.
Una política clara también permite distinguir entre asistencia tecnológica legítima, utilización no declarada y sustitución del trabajo intelectual que debía realizar el estudiante.
12. Hacia un modelo de evaluación de dos vías: prohibir o permitir con transparencia
Una propuesta que surge de este debate es adoptar políticas de evaluación diferenciadas, conocidas como enfoques de dos vías (two-lane approaches).
El principio consiste en reconocer que no todas las actividades educativas tienen que responder a las mismas reglas respecto de la inteligencia artificial.
En una primera modalidad, el uso de herramientas generativas puede estar restringido porque el objetivo de la actividad es evaluar una competencia individual específica.
En una segunda modalidad, la inteligencia artificial puede incorporarse como herramienta de trabajo, siempre que se establezcan condiciones de utilización, reconocimiento y responsabilidad.
Este enfoque evita dos posiciones extremas.
Por un lado, la prohibición indiscriminada de cualquier herramienta de inteligencia artificial, que puede resultar difícil de aplicar en un entorno tecnológico donde estas funciones ya están presentes en numerosos programas y servicios.
Por otro, la aceptación sin límites de contenidos automatizados, que podría vaciar de sentido determinadas actividades de aprendizaje y evaluación.
La diferenciación permite establecer expectativas más realistas.
También introduce una responsabilidad que no puede recaer exclusivamente en el estudiante: las instituciones deben explicar qué esperan de cada trabajo, qué herramientas pueden utilizarse y qué criterios se aplicarán para evaluar los resultados.
La transparencia, en este contexto, es tan importante como la tecnología.
13. Qué deberían hacer las instituciones antes de utilizar un detector de IA
La evidencia científica disponible permite establecer una serie de criterios que deberían considerarse antes de incorporar estas herramientas a los procesos académicos.
En primer lugar, es necesario exigir información verificable sobre el funcionamiento del sistema. Una institución debería conocer qué mide, cuáles son sus limitaciones, qué poblaciones fueron utilizadas para evaluarlo y qué tasas de error presenta en condiciones comparables con las de sus estudiantes.
En segundo término, resulta indispensable realizar pruebas con muestras lingüísticamente diversas.
No alcanza con evaluar una herramienta utilizando únicamente textos producidos por hablantes nativos, estudiantes de un determinado nivel educativo o documentos pertenecientes a una sola disciplina.
La escritura humana es diversa. Los modelos de evaluación deben contemplar esa diversidad.
También debería establecerse un procedimiento de revisión cuando un detector genera una alerta. El estudiante debe conocer los motivos del cuestionamiento, disponer de una oportunidad para explicar su trabajo y contar con una instancia de evaluación humana.
Finalmente, ninguna sanción debería basarse exclusivamente en una puntuación automática sin pruebas adicionales y un procedimiento adecuado.
Estos criterios no representan una renuncia a la integridad académica. Por el contrario, permiten defenderla mediante mecanismos más justos, transparentes y técnicamente responsables.
14. El futuro de la detección: entre los patrones estadísticos y la procedencia del contenido
La evolución de la inteligencia artificial obliga a revisar también las estrategias tecnológicas utilizadas para identificar el origen de los documentos.
Una de las líneas de investigación consiste en desarrollar mecanismos de procedencia que permitan aportar información sobre el origen de determinados contenidos.
Entre las alternativas estudiadas se encuentran las marcas de agua digitales, los registros de procedencia y los sistemas de documentación de las etapas de generación.
Sin embargo, estas soluciones tienen sus propias limitaciones.
Una marca de agua puede depender del sistema que genera el contenido, de las condiciones de utilización y de la conservación de determinadas características durante el procesamiento posterior.
Si un texto se transforma, traduce o modifica, la señal puede debilitarse o desaparecer, según el método utilizado.
Por otra parte, no todos los proveedores implementan mecanismos compatibles ni existe una solución universal que permita identificar cualquier texto generado por cualquier sistema.
La procedencia documental puede ofrecer información adicional, pero no debe confundirse con una prueba absoluta de autoría.
En este sentido, el desafío tecnológico consiste en desarrollar mecanismos que aporten evidencias verificables sin generar una nueva dependencia de indicadores opacos.
La identificación del origen de un contenido probablemente requiera combinar diferentes herramientas, registros y procedimientos de verificación.
Lo que parece cada vez menos razonable es esperar que una única puntuación estadística resuelva por sí sola una cuestión tan compleja.
15. Una discusión que también interpela al periodismo y al mundo profesional
Aunque buena parte de la controversia se desarrolla en las universidades, sus consecuencias alcanzan otros ámbitos.
En el periodismo, la comunicación institucional, la investigación científica y la producción de contenidos digitales, la inteligencia artificial ya forma parte de los procesos de trabajo.
Las organizaciones necesitan establecer criterios para distinguir entre asistencia tecnológica, automatización de tareas y producción intelectual original.
Sin embargo, utilizar un detector como mecanismo de certificación de autoría presenta las mismas dificultades que en el ámbito académico.
Un informe técnico redactado con terminología precisa puede presentar características estadísticas similares a las de un documento generado automáticamente. Lo mismo puede ocurrir con un artículo periodístico que respeta una estructura editorial convencional.
Por eso, las organizaciones deberían evaluar otros elementos: fuentes utilizadas, documentación de la investigación, responsabilidad sobre los datos, conocimiento del tema y trazabilidad del proceso de producción.
En el periodismo, además, existe una obligación que no puede delegarse en un algoritmo: comprobar la información antes de publicarla.
La discusión sobre la inteligencia artificial no debería desviar la atención de ese principio. Un texto puede haber sido escrito por una persona y contener información falsa, del mismo modo que un contenido asistido por IA puede incluir datos correctos si fue investigado y verificado adecuadamente.
La autoría y la veracidad son cuestiones diferentes.
Esta distinción será cada vez más importante a medida que las herramientas generativas se incorporen a las rutinas profesionales.
El verdadero desafío no es detectar máquinas, sino proteger el valor del pensamiento humano
La controversia sobre los detectores de inteligencia artificial revela un problema que va mucho más allá de las limitaciones de un programa informático.
Las investigaciones desarrolladas en los últimos años muestran que los sistemas de clasificación pueden cometer errores, reproducir sesgos lingüísticos y presentar dificultades para reconocer contenidos modificados. También advierten que determinadas características de la escritura humana, como la regularidad gramatical, la precisión terminológica y la previsibilidad sintáctica, pueden influir en los resultados.
El estudio de Stanford expuso una situación particularmente preocupante para los estudiantes no nativos de inglés. La investigación de Weber-Wulff documentó limitaciones en 14 herramientas comerciales y públicas. La retirada del clasificador de OpenAI y la decisión de Vanderbilt de desactivar la función de Turnitin mostraron que las dudas sobre la eficacia de estos mecanismos también alcanzaron a empresas tecnológicas e instituciones universitarias.
No se trata de negar que exista fraude académico ni de desconocer los desafíos que plantea la inteligencia artificial generativa. Tampoco de sostener que todos los detectores carecen de utilidad.
La cuestión es otra: ninguna estimación estadística debería convertirse automáticamente en una acusación contra una persona.
La calidad de un documento no puede medirse únicamente por su imprevisibilidad. Una argumentación ordenada, un vocabulario preciso y una gramática impecable siguen siendo expresiones legítimas del conocimiento y del trabajo intelectual.
En adelante, las instituciones tendrán que encontrar mecanismos capaces de preservar la integridad académica sin castigar las diferencias lingüísticas, las preferencias comunicativas o el esfuerzo por mejorar la escritura.
La respuesta probablemente no esté en desarrollar detectores cada vez más severos, sino en construir sistemas de evaluación que contemplen el proceso, la comprensión, la investigación y la capacidad de defender las propias ideas.
La inteligencia artificial puede modificar profundamente la producción de contenidos, pero no debería modificar un principio básico: una persona merece ser evaluada por evidencias concretas, no condenada por una semejanza estadística.
El futuro de la educación y de la comunicación profesional dependerá, en buena medida, de que la tecnología funcione como una herramienta al servicio del conocimiento y no como un sustituto del criterio humano.